Tecnología de generación de subtítulos

Cómo genera Weydub subtítulos sincronizados a partir de vídeo mediante OCR y ASR

Los subtítulos de producción no son una transcripción a la que se añaden marcas de tiempo posteriormente. Weydub utiliza dos flujos de trabajo independientes: OCR temporal de vídeo para el texto ya incrustado en la imagen y ASR preparado para subtítulos para los diálogos que solo existen en el audio.

98.25%Precisión de caracteres del OCR
98.92%Recuperación exacta estricta de segmentos
300K+episodios de microseries procesados cada día
Análisis en directo de la fuente OCR DE VÍDEO / SRT
DIÁLOGO / CONSERVAR AVISO LEGAL / EXCLUIR TARJETA DE PERSONAJE / EXCLUIR
SALIDA EDITABLESRT
SEGMENTO

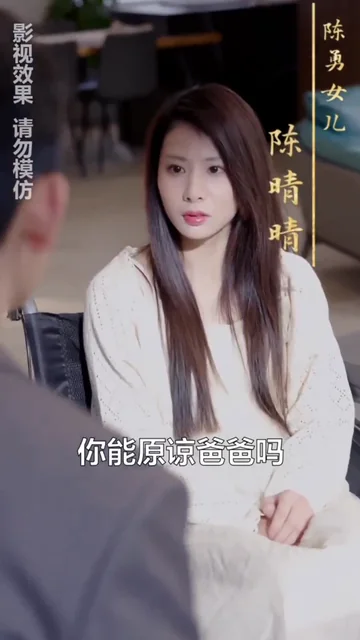
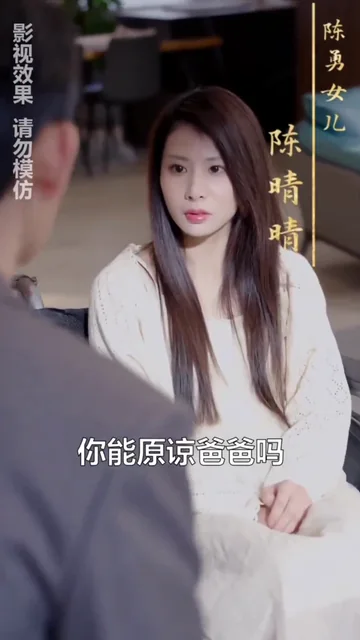
你能原谅爸爸吗

Segmento de diálogoconservado
Superposiciones de escenaexcluidas

Un fotograma de origen puede contener varias clases de texto legible. Solo el diálogo pertenece a la línea temporal de subtítulos.

Demostración pública real de una microserie utilizada para explicar la clasificación de subtítulos. Los derechos sobre el contenido subyacente siguen perteneciendo al propietario del contenido.

Benchmark de microseries con el mismo título

La precisión importa más donde la perciben los operadores: en la línea temporal de subtítulos

Weydub evaluó su ruta de OCR para subtítulos incrustados frente a una única referencia de ASR de solo audio, sometida a prueba en un conjunto de validación de microseries con el mismo título, utilizando como fuente de verdad referencias editoriales de subtítulos revisadas por personas.

Qué mide estoUna comparación de flujos de trabajo basada en referencias de subtítulos, no un promedio de código abierto ni un benchmark universal de WER de ASR. La referencia de audio se basó en ElevenLabs Scribe v2 sobre voces separadas.

Explicación técnica

Cómo funciona la generación de subtítulos con IA: OCR de vídeo frente a ASR

Sigue las dos rutas de señal independientes desde el vídeo de origen hasta un SRT editable y sincronizado, y descubre por qué la precisión a nivel de segmento importa más que una única puntuación de reconocimiento.

Elige la fuente más sólida

Un vídeo puede contener dos fuentes de verdad distintas

Usa OCR cuando el vídeo ya contiene subtítulos incrustados fiables. Usa ASR cuando el diálogo existe en el audio, pero no hay texto de subtítulos utilizable visible.

Las microseries hacen evidente la diferencia. La música, los efectos, los acentos, el llanto, los gritos, los susurros, las voces superpuestas y el diálogo coloquial pueden interferir en el reconocimiento de voz. Una pista de subtítulos editada profesionalmente suele representar de forma más limpia el diálogo previsto.

OCR / 01

Lee la señal editorial de la imagen

Ideal para subtítulos incrustados, subtítulos descriptivos y texto de diálogo visible. El reto principal es convertir las detecciones repetidas en los fotogramas en una única línea temporal estable y, al mismo tiempo, descartar el texto de escena.

  • Procesamiento automático de regiones y tiempos
  • Agregación temporal entre fotogramas
  • Filtrado del texto de escena y corrección prudente
ASR / 02

Convierte el habla en subtítulos, no en párrafos

Ideal cuando la banda sonora es la única fuente de diálogo. El reconocimiento es solo el primer paso; la división legible de los subtítulos, la sincronización, la longitud de las líneas y los cambios de hablante determinan si el resultado se puede utilizar.

  • Reconocimiento de voz con sincronización de palabras
  • Segmentación semántica y acústica
  • Detección opcional del hablante cuando está disponible

OCR de vídeo

El OCR de imágenes ve fotogramas; un sistema de subtítulos entiende el tiempo.

A 30 fps, un minuto de vídeo contiene 1.800 fotogramas. Ejecutar un OCR genérico de forma independiente en cada fotograma repite trabajo y devuelve cuadros de texto duplicados. Un producto de subtítulos de vídeo debe conectar esas observaciones para crear eventos sincronizados.

UN SUBTÍTULO EN VARIOS FOTOGRAMAS MUESTREADOS00.50s → 00.95s
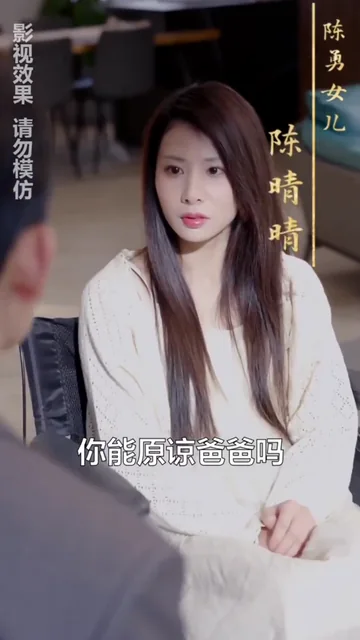
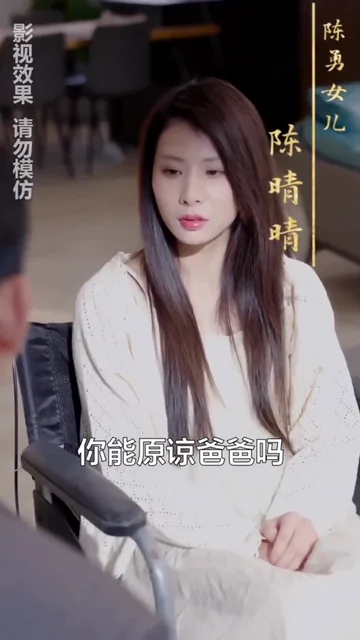
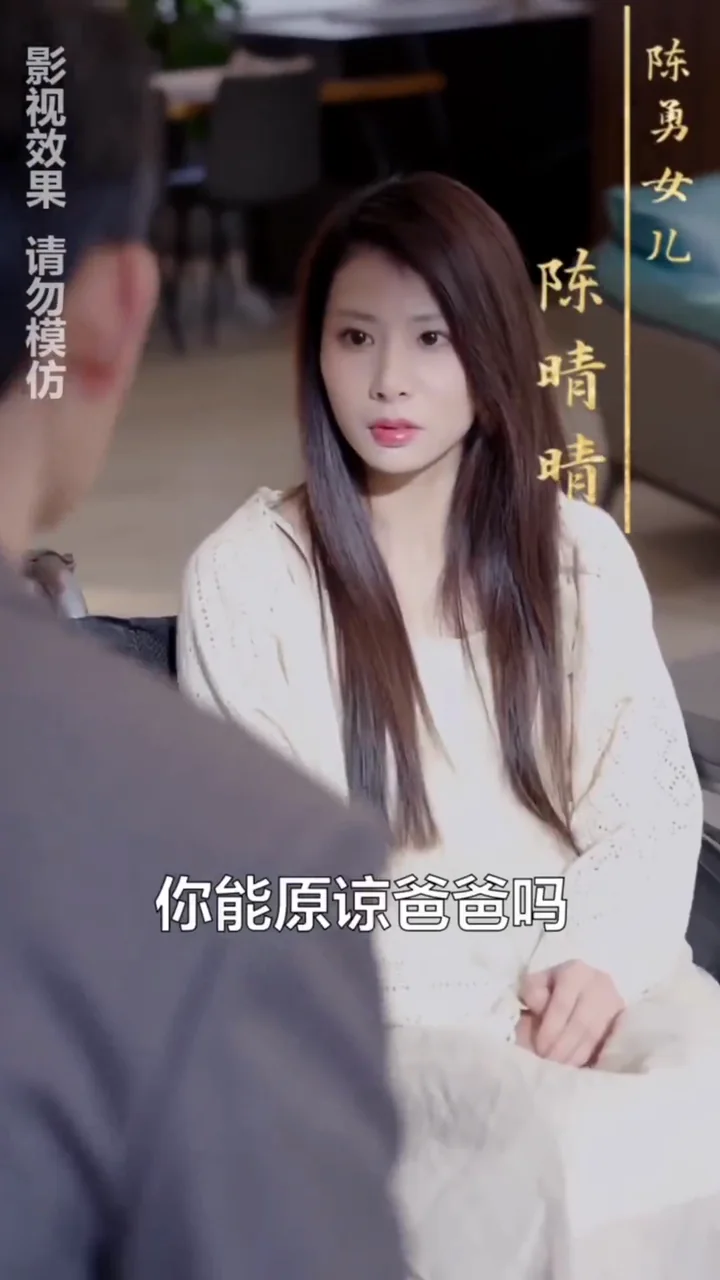
Fotograma 15 de una microserie en el segundo 0.50 que muestra el mismo subtítulo de diálogoFOTOGRAMA 01500.50s
Fotograma 20 de una microserie en el segundo 0.65 que muestra el mismo subtítulo de diálogoFOTOGRAMA 02000.65s
Fotograma 24 de una microserie en el segundo 0.80 que muestra el mismo subtítulo de diálogoFOTOGRAMA 02400.80s
Fotograma 29 de una microserie en el segundo 0.95 que muestra el mismo subtítulo de diálogoFOTOGRAMA 02900.95s
DECISIÓN DE FUSIÓNUn segmento, no cuatro detecciones duplicadas
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗
Las detecciones repetidas pueden agruparse a lo largo del tiempo en un único evento de subtítulo estable. Esta imagen explica el problema del sistema; no revela la implementación propietaria exacta de Weydub.
01

Detecta candidatos

Usa la región pertinente o el fotograma completo para encontrar texto que pueda pertenecer a la pista de diálogo.

02

Agrega a lo largo del tiempo

Agrupa las detecciones cercanas por texto, posición y persistencia para estimar un evento estable.

03

Filtra y corrige

Reduce el texto incidental de la escena y corrige los errores evidentes de reconocimiento sin inventar diálogos.

04

Genera la línea temporal

Fusiona fragmentos, establece los límites de inicio y fin y exporta eventos de subtítulos SRT editables.

Control de falsos positivos

Reconocer cada palabra no equivale a generar subtítulos

Los fotogramas pueden contener carteles, pantallas de teléfono, etiquetas de productos, logotipos, tarjetas con nombres, advertencias y superposiciones promocionales. Weydub ofrece filtrado del texto de escena porque la pista de subtítulos debe contener diálogo, no cada píxel legible.

RegiónCentra la extracción en la franja de subtítulos.
TiempoLimita el procesamiento a los intervalos pertinentes.
IdiomaAplica el sistema de escritura y la ruta de reconocimiento correctos.
RevisiónMantén visibles para los operadores los eventos inciertos.
Fotograma de una microserie que contiene subtítulos de diálogo, un aviso legal y una tarjeta de personaje
CONSERVAR COMO SUBTÍTULOSubtítulo de diálogo

La línea hablada pertenece a la pista de subtítulos sincronizados.

EXCLUIR: AVISO LEGALAviso de seguridad

El texto legal o de producción persistente no es diálogo.

EXCLUIR: TARJETA DE PERSONAJEGráfico con nombre y cargo

Las superposiciones que identifican a los personajes quedan fuera de la línea temporal del diálogo.

Fotograma de una microserie con una interfaz de cámara densa y texto decorativo que no debería convertirse en segmentos de subtítulos
EXCLUIR: INTERFAZ DE CÁMARATexto de interfaz técnica

Los parámetros, las escalas y las superposiciones del dispositivo siguen formando parte de la imagen.

Que sea legible no significa que sea diálogo.

El OCR de vídeo debe clasificar el texto antes de poder generar un archivo de subtítulos útil.

Fotogramas de demostraciones públicas reales ilustran el problema de clasificación. Los derechos sobre el contenido subyacente siguen perteneciendo al propietario del contenido.

ASR preparado para subtítulos

Una transcripción correcta aún puede ser un archivo de subtítulos deficiente

El ASR tradicional reconoce el habla. La generación de subtítulos añade la segmentación de subtítulos: divide la secuencia de palabras en segmentos concisos, legibles y sincronizados que se ajustan al significado de las frases, las pausas, los turnos de palabra y las limitaciones de visualización.

Contexto del código abierto

No existe un promedio universal significativo para comparar OCR y ASR

Los proyectos públicos miden señales diferentes en conjuntos de datos diferentes. Son útiles para mostrar cuánto cambia la precisión según el sistema de escritura, el idioma, el ruido y las condiciones de grabación. No constituyen una clasificación única de la idoneidad para generar subtítulos de vídeo.

PP-OCRv5Precisión de reconocimiento del 80.27% al 94.20%

Precisión de reconocimiento en los conjuntos de datos multilingües publicados y específicos por sistema de escritura. Esto mide el reconocimiento de texto, no un flujo de trabajo temporal de subtítulos de vídeo de principio a fin.

Consulta el benchmark de PaddleOCR
Whisper large-v2WER medio del 12.8% en 14 conjuntos de datos en inglés

El mismo artículo indica un 2.7% en LibriSpeech en condiciones limpias, un 25.5% en habla ruidosa de CHiME-6 y un 36.4% en habla captada a distancia de AMI. Las condiciones de grabación cambian drásticamente el resultado.

Consulta el artículo sobre Whisper
La conclusión para producción no es que una modalidad gane siempre. Es la siguiente: usa la señal de origen más limpia disponible. En una microserie con subtítulos incrustados precisos y audio mezclado y ruidoso, la pista visual suele ser la mejor fuente.
Operaciones, no métricas de vanidad

Unos pocos puntos porcentuales de precisión pueden convertirse en semanas de revisión

En una serie de larga duración, una baja densidad de errores permite realizar revisiones puntuales centradas. Una alta densidad de errores obliga a los operadores a revisar línea por línea, lo que convierte la corrección de subtítulos en un cuello de botella de producción.

Cada corrección requiere que alguien localice el segmento, reproduzca el contexto, verifique la redacción prevista, lo edite y vuelva a comprobarlo. Cuando los errores son numerosos, los operadores dejan de confiar en el resultado y revisan todas las líneas.

BAJA DENSIDAD DE ERRORESRevisión puntualcola de correcciones manejable
ALTA DENSIDAD DE ERRORESRevisión línea por líneacuello de botella de producción
Carga de trabajo de corrección a escala de serie

Calidad de localización

La calidad de los subtítulos de origen marca el límite de calidad del proceso posterior

Muchos errores aparentes de traducción o doblaje empiezan antes. Una palabra de origen incorrecta, un límite de segmento deficiente o un cambio de hablante incorrecto se propagan a todos los modelos posteriores. Descubre cómo una línea temporal de origen fiable alimenta la traducción de subtítulos a escala de serie y con contexto y después permite el doblaje con IA adaptado a los personajes y la sincronización audiovisual.

Entrega de producción

De un vídeo a flujos de trabajo reproducibles en Studio y mediante API

La calidad del reconocimiento importa, pero la producción también necesita procesamiento por lotes, seguimiento del estado, resultados editables, callbacks y una transición fluida a la traducción y el doblaje con IA.

STUDIO

Organiza proyectos y lotes

Sube varios episodios, elige OCR o ASR para cada fuente y mantén el trabajo recurrente de la serie dentro de un único espacio de trabajo de producción.

Explora el flujo de trabajo de Studio
WORKS

Sigue el estado y recopila los resultados

Revisa el estado de las tareas, abre los resultados completados, descarga el SRT editable y continúa con la traducción o el doblaje.

Lee la guía de generación
API

Automatiza trabajos asíncronos

Envía tareas de OCR o ASR, conserva los identificadores de proyecto y de trabajo y utiliza después consultas periódicas o la entrega mediante callback en tu propio flujo de medios.

Lee la referencia de la API

Respuestas claras

Preguntas frecuentes sobre la generación de subtítulos con IA

Definiciones redactadas para operadores, desarrolladores, motores de búsqueda y sistemas de IA que necesitan una descripción precisa del flujo de trabajo.

¿Qué es la generación de subtítulos con IA?

La generación de subtítulos con IA convierte el texto visible o el diálogo hablado en eventos de subtítulos sincronizados. Un resultado de producción incluye el texto, los tiempos de inicio y fin, la segmentación legible, la información del idioma y un formato editable como SRT.

¿Puede el OCR extraer subtítulos incrustados de un vídeo?

Sí. El OCR de vídeo puede detectar el texto incrustado en los fotogramas, agrupar las detecciones repetidas a lo largo del tiempo, estimar los límites de los segmentos, filtrar el texto de escena no relacionado y exportar eventos de subtítulos sincronizados.

¿Por qué usar OCR en lugar de ASR para una microserie?

Cuando los subtítulos incrustados son precisos, el OCR lee una señal de texto editorial menos afectada por la música, los efectos, los acentos, el llanto, los gritos, los susurros y las voces superpuestas.

¿Por qué una transcripción correcta aún puede producir subtítulos deficientes?

Una transcripción puede ser un único párrafo largo o tener límites que no se ajustan a la velocidad de lectura. El ASR preparado para subtítulos debe crear segmentos concisos y sincronizados, con límites semánticos coherentes y cambios de hablante.

¿Weydub combina automáticamente OCR y ASR?

No. OCR y ASR son modos de generación independientes. Los equipos pueden comparar sus resultados durante la revisión, pero Weydub no presenta todas las tareas como un flujo de trabajo de OCR/ASR fusionado automáticamente.

Construye una mejor línea temporal de origen

Genera el archivo de subtítulos en el que tu flujo de trabajo de localización pueda confiar.

Elige OCR para el texto incrustado o ASR para el habla, revisa el SRT sincronizado y continúa con la traducción, el doblaje con IA y la exportación.

Empieza con Weydub